Cấp cứu, code lỗi đi cmn hết dữ liệu Elasticsearch trên production rồi anh

Không sớm thì muộn ai trong chúng ta cũng sẽ được nghe câu nói trên  . Phốt everywhere

Cách đây không lâu mình và khách hàng phải xây dựng một hệ thống nội bộ cho họ dùng để tìm kiếm, thống kê dữ liệu trong Elasticsearch (đại loại như Kibana), tuy không nhiều chức năng như Kibana nhưng công việc này đã cho mình rất nhiều kiến thức về Elasticsearch.
Hey, what’s up man?
Với vai trò là người quản lý server của khách, thì việc biết cách sao lưu (backup or snapshot), phục hồi (restore), đánh lại chỉ mục (re-index), index aliases & zero downtime (éo biết dịch thế nào, cụ thể là bạn tạo 1 cái mặt nạ, người dùng nhìn vào cái mặt nạ đó nhưng méo biết đằng sau nó là index nào, mặc cho admin switch mệt nghỉ  )
Trong bài viết này tôi sẽ mô tả cách mà tôi thực hiện việc sao lưu và đánh lại index trên Elasticsearch.
Nếu máy tính bạn không có Elasticsearch, Kibana để thực hành thì đừng lo, hãy cài docker/docker-compose và dùng sẵn stack này nhé.
Sau khi chạy lệnh $ docker-compose up , đợi các service ready hết các bạn vào Kibana Dev Console là có thể bắt tay thử liền.
Prepare
Trước hết hãy chuẩn bị sẵn dữ liệu mẫu để thao tác. Ở đây mình sẽ tạo sẵn một index tên là messages_v1, chứa toàn bộ dữ liệu về tin nhắn chat của mình chẳng hạn 
PUT messages_v1
{
  "settings" : {
    "analysis" : {
      "analyzer":{
        "custom_analyzer":{
           "type": "custom",
           "filter": [
              "lowercase"
           ],
           "tokenizer": "whitespace"
        }
      }
    }
  },
  "mappings": {
    "doc": {
      "properties": {
        "content": {
          "type": "text",
          "analyzer": "custom_analyzer"
        },
        "created_at": {
          "type":   "date",
          "format": "yyyy-MM-dd HH:mm:ss"
        }
      }
    }
  }
}
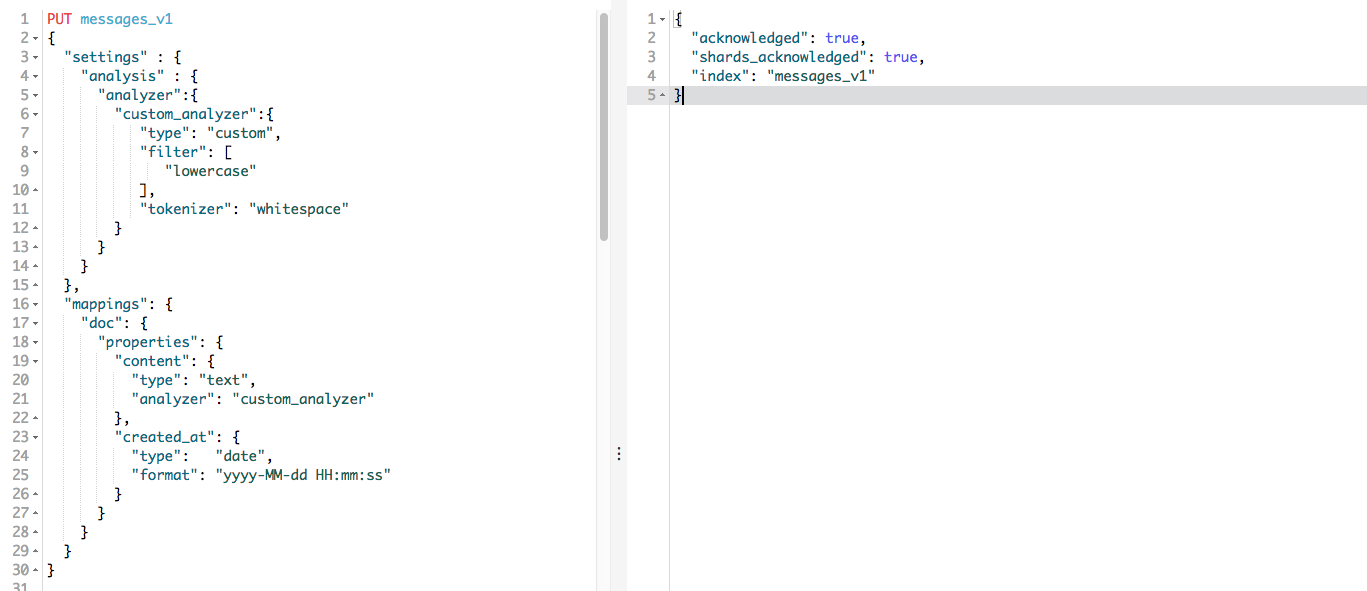
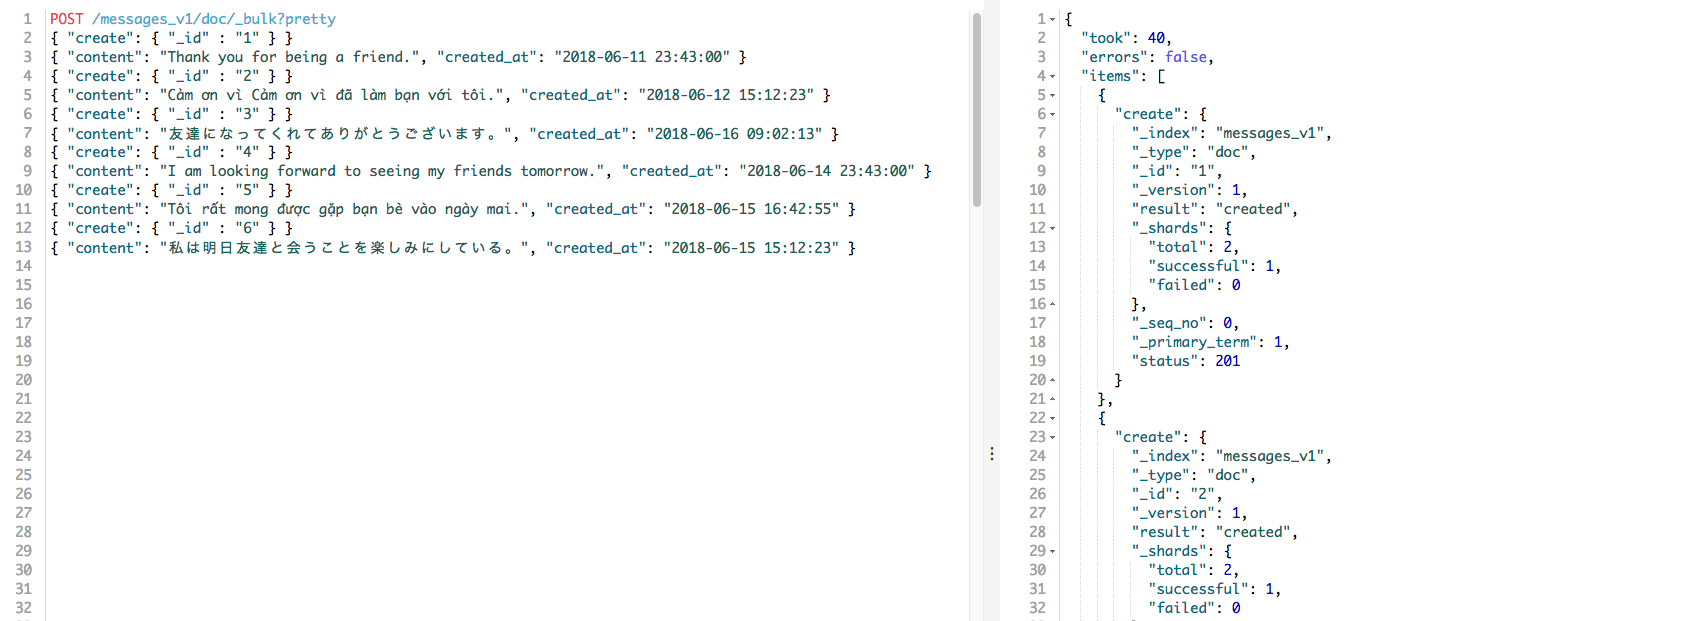
Sau đó tạo thêm đôi ba tin nhắn vào index này:
POST /messages_v1/doc/_bulk?pretty
{ "create": { "_id" : "1" } }
{ "content": "Thank you for being a friend.", "created_at": "2018-06-11 23:43:00" }
{ "create": { "_id" : "2" } }
{ "content": "Cảm ơn vì Cảm ơn vì đã làm bạn với tôi.", "created_at": "2018-06-12 15:12:23" }
{ "create": { "_id" : "3" } }
{ "content": "友達になってくれてありがとうございます。", "created_at": "2018-06-16 09:02:13" }
{ "create": { "_id" : "4" } }
{ "content": "I am looking forward to seeing my friends tomorrow.", "created_at": "2018-06-14 23:43:00" }
{ "create": { "_id" : "5" } }
{ "content": "Tôi rất mong được gặp bạn bè vào ngày mai.", "created_at": "2018-06-15 16:42:55" }
{ "create": { "_id" : "6" } }
{ "content": "私は明日友達と会うことを楽しみにしている。", "created_at": "2018-06-15 15:12:23" }
Index aliases & Zero downtime
Tại sao mình lại đưa phần này lên đầu tiên, đơn giản vì nó khá quan trọng  Vấn đề ở chỗ khi có 1 cục dữ liệu đã index mà bạn muốn index lại hay chỉ đơn giản là update lại tên của cục dữ liệu đó, thì cũng sẽ mất một khoảng thời gian nhất định. Tất nhiên với tư cách là một người sử dụng, ko ai muốn nhìn thấy dòng chữ
"The system is in maintenance mode. Please contact your administrator or try again later." :))
Index alias giống như shortcut hay symbolic link, trỏ tới một hay nhiều indices, có thể được sử dụng như index name trong mọi API. Aliases cho chúng ta sự linh hoạt khi sử dụng Elasticsearch như:
- Chuyển đổi từ một index này sang một index khác trên cluster
- Nhóm nhiều indices lại (ví dụ,
last_three_months) - Tạo “views” trên một tập con documents trong index
PUT /messages_v1/_alias/messages
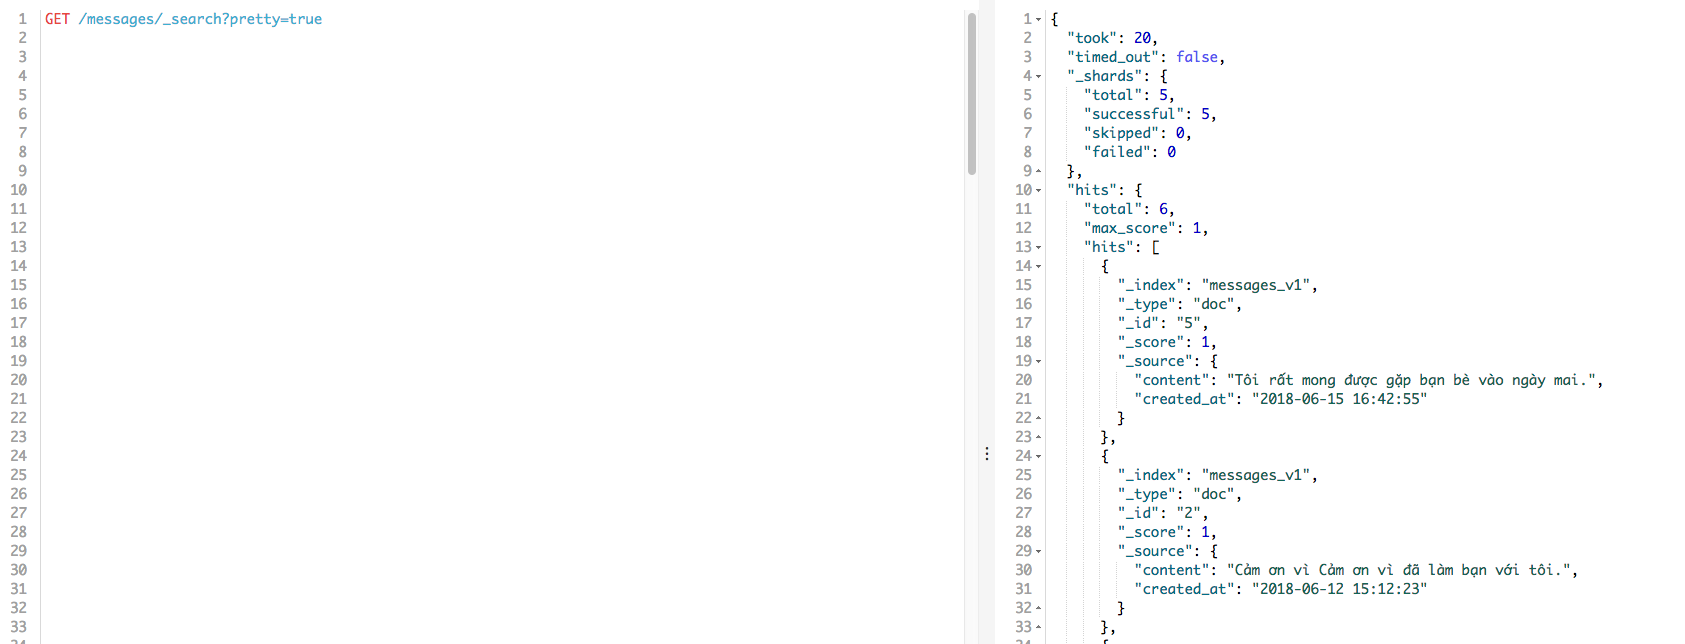
Ở đây mình tạo alias là messages cho index messages_v1. Thử search với alias phát 
GET /messages/_search?pretty=true
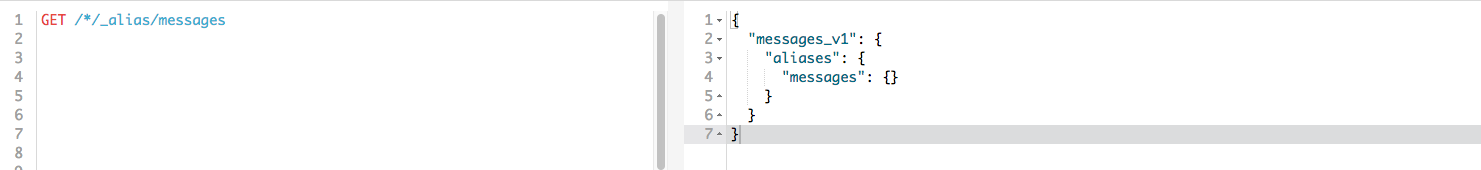
Ngược lại ta có thể kiểm tra xem alias: messages point tới index nào 
GET /*/_alias/messages
Vậy khi muốn cập nhật lại alias, trỏ sang 1 index khác thì sao ? Vui lòng đọc phần này nhé
Snapshot/Backup
Khi sao lưu dữ liệu bạn cần nhớ một điều:
- Một snapshot của index được tạo trong bản 5.x thì có thể phục hồi trên bản 6.x.
- Một snapshot của index được tạo trong bản 2.x thì có thể phục hồi trên bản 5.x.
- Một snapshot của index được tạo trong bản 1.x thì có thể phục hồi trên bản 2.x.
Repository
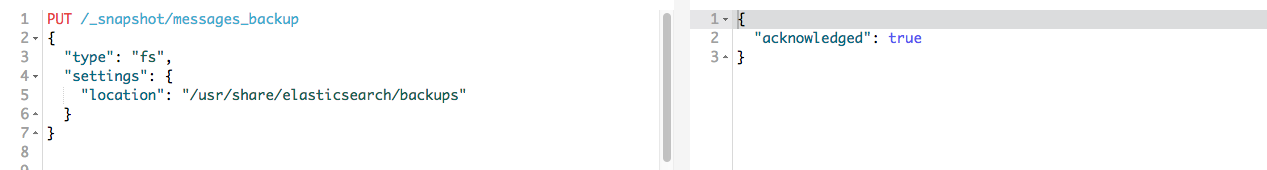
Bạn cần tạo repository trước khi sao lưu hay phục hổi dữ liệu. Elastic khuyến khích người dùng nên tạo mới snapshot repository cho mỗi phiên bản elasticsearch quan trọng. Repository hợp lệ phụ thuộc vào kiểu của repository.
Nếu bạn đăng ký một snapshot cho nhiều cluster thì chỉ duy nhất 1 cluster là có quyền write vào repository. Tất các các clusters khác kết nối vào repository để chỉ có quyền readonly.
- Tạo folder backup. Nếu bạn không dùng stack này hãy dùng lệnh sau:
mkdir -p /usr/share/elasticsearch/backups - Đăng ký backup location trên master và các nodes của Elasticsearch bằng cách thêm dòng sau vào file
elasticsearch.ymlpath.repo: ["/usr/share/elasticsearch/backups"] - Tạo repository
PUT /_snapshot/messages_backup
{
"type": "fs",
"settings": {
  "location": "/usr/share/elasticsearch/backups"
}
}
- Tiến hành sao lưu dữ liệu trong index
messages_v1PUT /_snapshot/messages_backup/snapshot_1?wait_for_completion=true { "indices": "messages_v1", "ignore_unavailable": true, "include_global_state": false }Tham số
wait_for_completionđược thêm vào đồng nghĩa với việc khi nào request trả về response thì việc backup mới hoàn tất.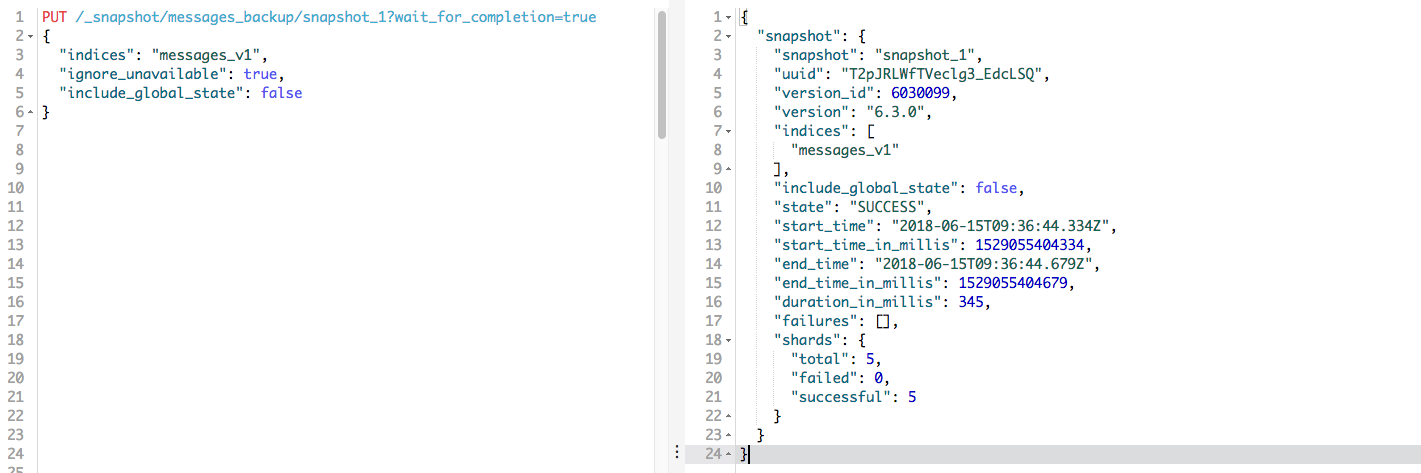
Restore
Một snapshot có thể được restore (phục hồi) bởi câu lệnh sau:
POST /_snapshot/messages_backup/snapshot_1/_restore
Câu lệnh này sẽ khôi phục lại dữ liệu của index đã backup với nguyên trạng cả tên index, … Nên nếu trong hệ thống có index trùng tên với index trong snapshot thì chúng ta sẽ gặp lỗi:
{
  "error": {
    "root_cause": [
      {
        "type": "snapshot_restore_exception",
        "reason": "[messages_backup:snapshot_1/T2pJRLWfTVeclg3_EdcLSQ] cannot restore index [messages_v1] because an open index with same name already exists in the cluster. Either close or delete the existing index or restore the index under a different name by providing a rename pattern and replacement name"
      }
    ],
    "type": "snapshot_restore_exception",
    "reason": "[messages_backup:snapshot_1/T2pJRLWfTVeclg3_EdcLSQ] cannot restore index [messages_v1] because an open index with same name already exists in the cluster. Either close or delete the existing index or restore the index under a different name by providing a rename pattern and replacement name"
  },
  "status": 500
}
Do đó nếu muốn restore snapshot, nhưng đổi tên index ta có thể dùng lệnh chi tiết hơn
POST /_snapshot/messages_backup/snapshot_1/_restore
{
  "indices": "messages_v1",
  "ignore_unavailable": true,
  "include_global_state": false,
  "rename_pattern": "messages_(.+)",
  "rename_replacement": "restored_messages_$1"
}
- Elasticsearch sẽ dựa vào pattern khai báo trong
rename_patternđể tìm index có tên tương ứng và thay thế theo quy tắc khai báo trongrename_replacement.
Sau khi chạy câu lệnh trên ta có kết quả sau:
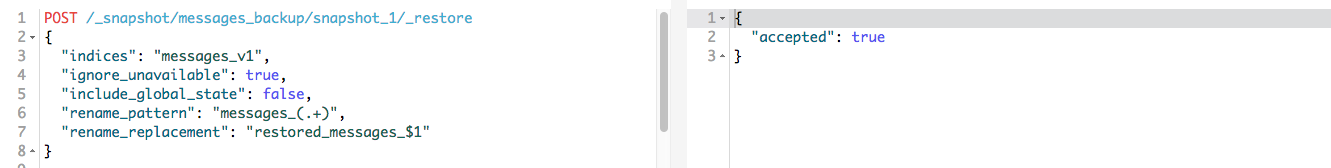 List all index ta thấy
 ほら
restored_messages_v1

Re-index
Cho dù bạn có thể thêm các
type(kiểu) mới vào chỉ mục hoặc thêm cácfield(trường) mới vàotype(kiểu), thì bạn cũng không thể làm điều đó vớianalyzerscũng như áp dụng các thay đổi cho các trường hiện có. Nếu bạn làm như vậy, dữ liệu đã được lập chỉ mục sẽ không chính xác và các tìm kiếm của bạn sẽ không còn hoạt động như mong đợi.

Vâng, đó chính là lý do chúng ta cần tới chức năng Reindex. Trên documentation của Elasticsearch: The Definitive Guide có mô tả
To reindex all of the documents from the old index efficiently, use scroll to retrieve batches of documents from the old index, and the bulk API to push them into the new index.
Đại loại là họ khuyên chúng ta nên sử dụng scroll để lấy từng mảng dữ liệu document nhỏ, sau đó mới push vào new_index. Mình thấy cách này hay đấy nhưng tốn công quá =))) Tuy nhiên với các hệ thống có lượng dữ liệu lớn thì bạn nên làm theo cách mà tài liệu khuyến khích nhé 
Ta làm đơn giản hơn:
- Tạo một index mới. Ở đây tôi tạo index có tên là
messages_v2với việc sử dụng bộanalyzercó tên là kuromoji, giúp phân tách tiếng Nhật tốt hơn.PUT messages_v2 { "settings" : { "analysis" : { "analyzer":{ "custom_analyzer":{ "type": "custom", "tokenizer": "kuromoji_tokenizer" } } } }, "mappings": { "doc": { "properties": { "content": { "type": "text", "analyzer": "custom_analyzer" }, "created_at": { "type": "date", "format": "yyyy-MM-dd HH:mm:ss" } } } } } - Copy dữ liệu từ index cũ sang index mới và đánh chỉ mục lại
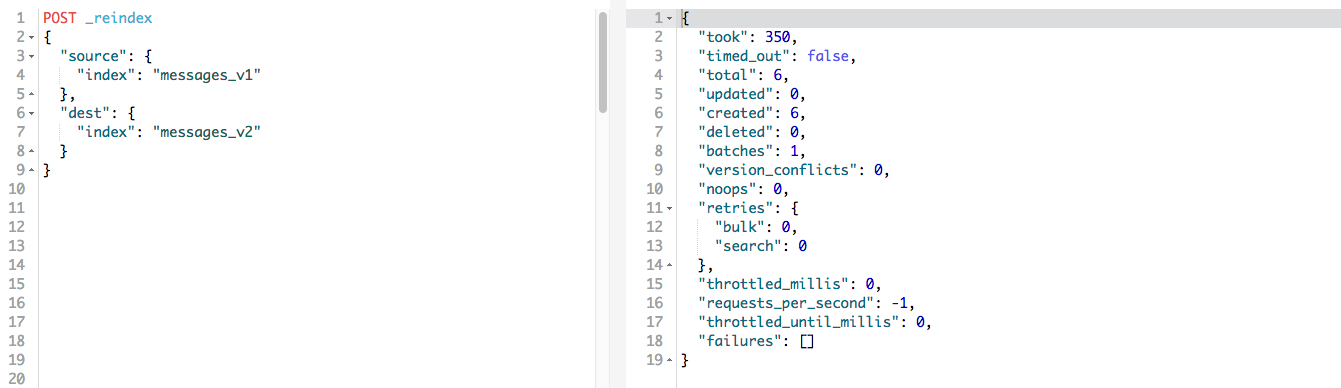
  POST _reindex
  {
    "source": {
      "index": "messages_v1"
    },
    "dest": {
      "index": "messages_v2"
    }
  }
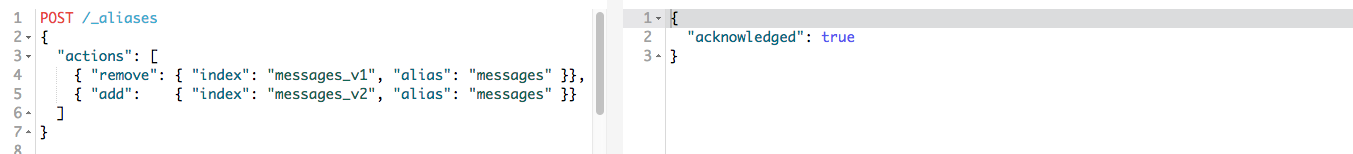
- Một bước quan trọng để hệ thống không bị down time (gián đoạn) đó là cập nhật lại alias sang index mới
  POST /_aliases
  {
    "actions": [
      { "remove": { "index": "messages_v1", "alias": "messages" }},
      { "add":    { "index": "messages_v2", "alias": "messages" }}
    ]
  }
- Xác nhận lại alias messages phát

GET /*/_alias/messages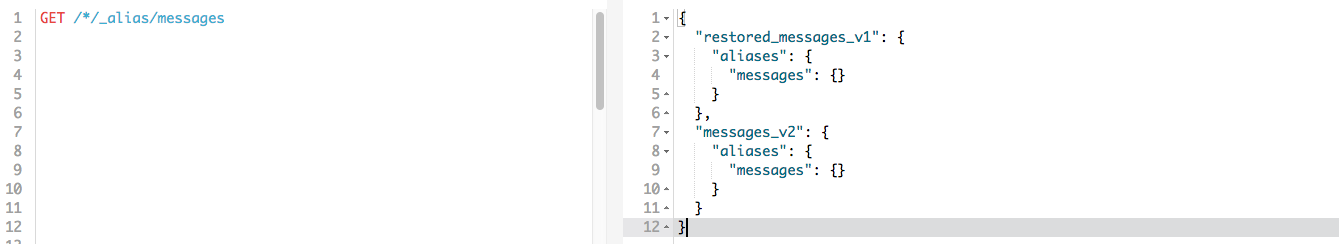 WTF ! Hoá ra là lúc restore snapshot nó phục hồi luôn cả trạng thái alias trước đó. Cụ thể là
messagestrước point tớimessages_v1thì giờ có cảrestored_messages_v1.Chuẩn cmnr, mình thử search all phát ra gấp đôi số lượng bản ghi:
GET /messages/_search?pretty=true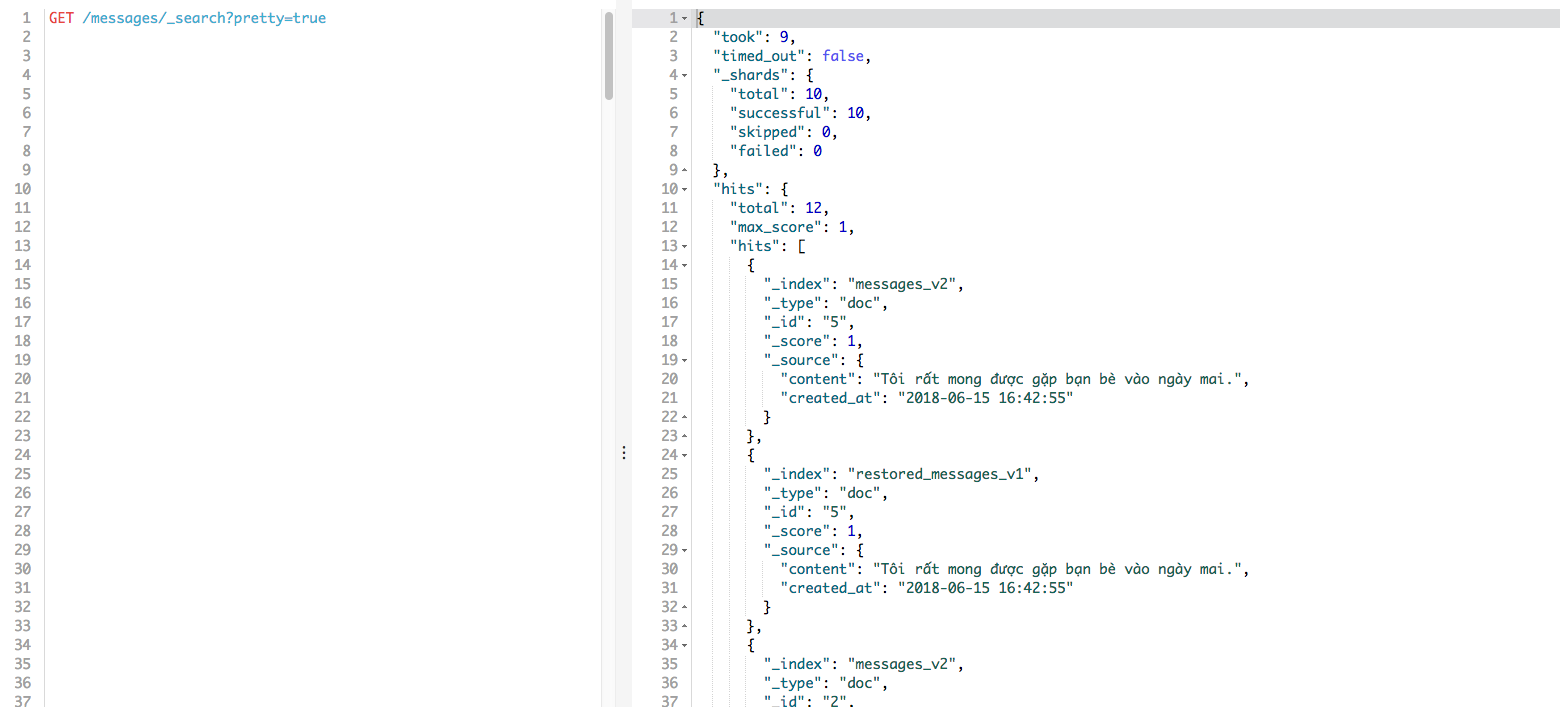 Ta remove luôn, tránh gây hậu hoạ về sau

  POST /_aliases
  {
    "actions": [
      { "remove": { "index": "restored_messages_v1", "alias": "messages" }}
    ]
  }
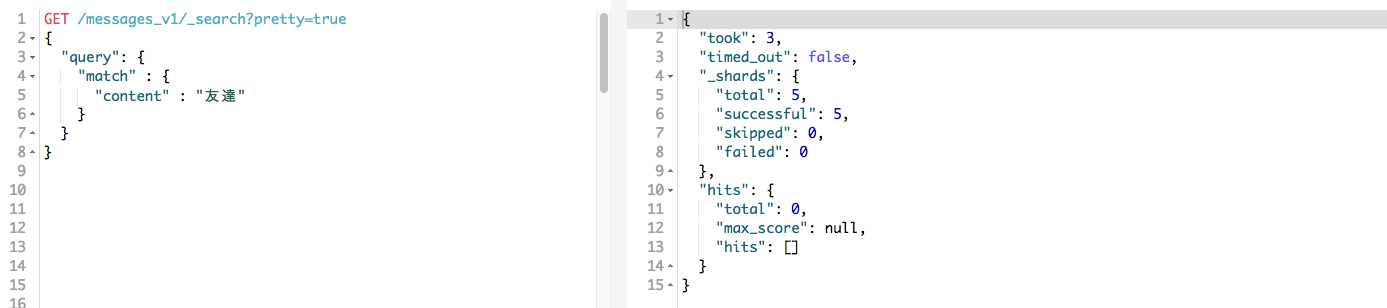
Sau khi thực hiện reindex và switch lại alias index sang messages_v2. Hãy thử search với 1 keyword tiếng Nhật. Ví dụ: 友達 (Bạn bè)
Với bản messages_v1
GET /messages_v1/_search?pretty=true
{
  "query": {
    "match" : {
      "content" : "友達"
    }
  }
}
Méo có kết quả nào do dùng bộ analyzer với tokenizer là dấu cách.
Với bản messages (hay thực chất là messages_v2)
GET /messages/_search?pretty=true
{
  "query": {
    "match" : {
      "content" : "友達"
    }
  }
}
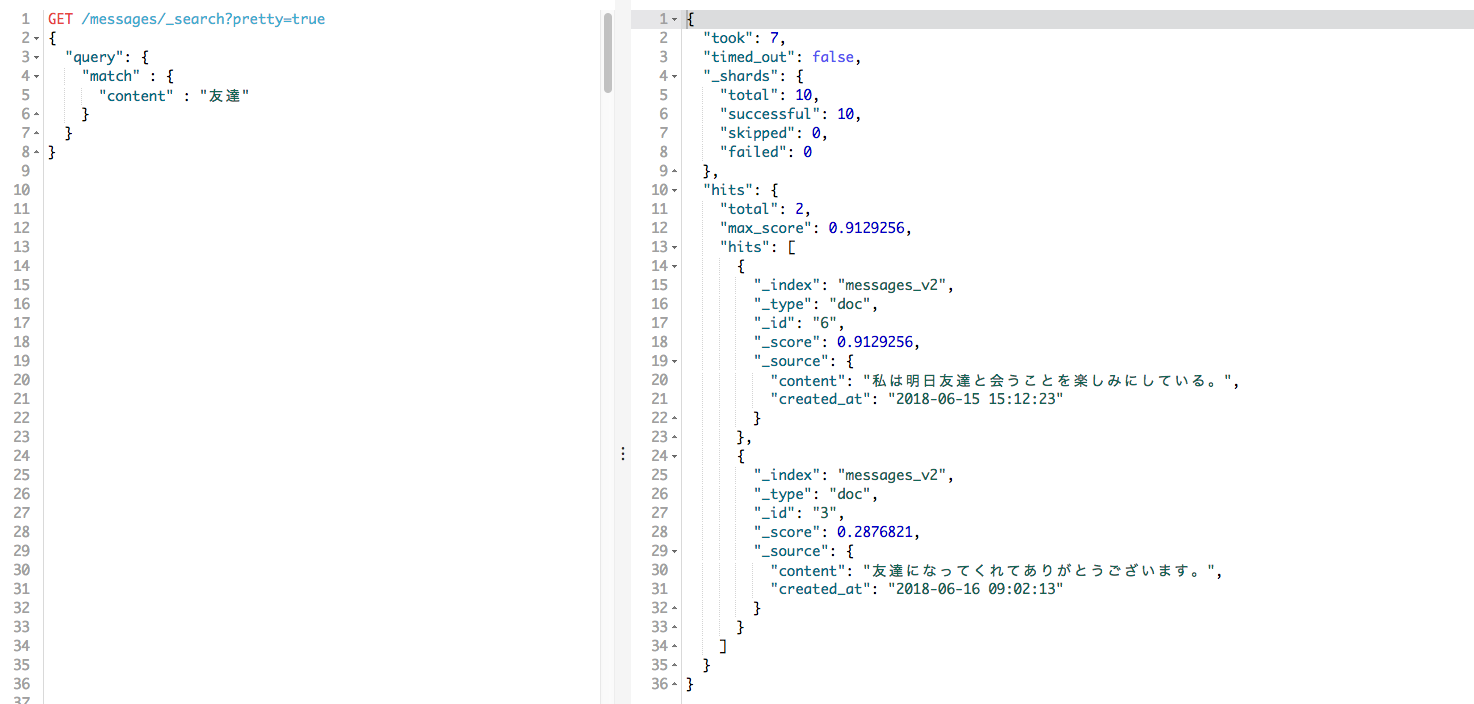
Các bạn biết tại sao lại thế hok, đơn giản thôi, tôi dùng kuromoji và nó tách các term tiếng Nhật ra chuẩn vãi lềnh
Để test các term được sinh ra như thế nào, bạn có thể dùng lệnh sau để xem chi tiết term trong 1 document:
GET /messages_v2/doc/3/_termvectors?fields=content
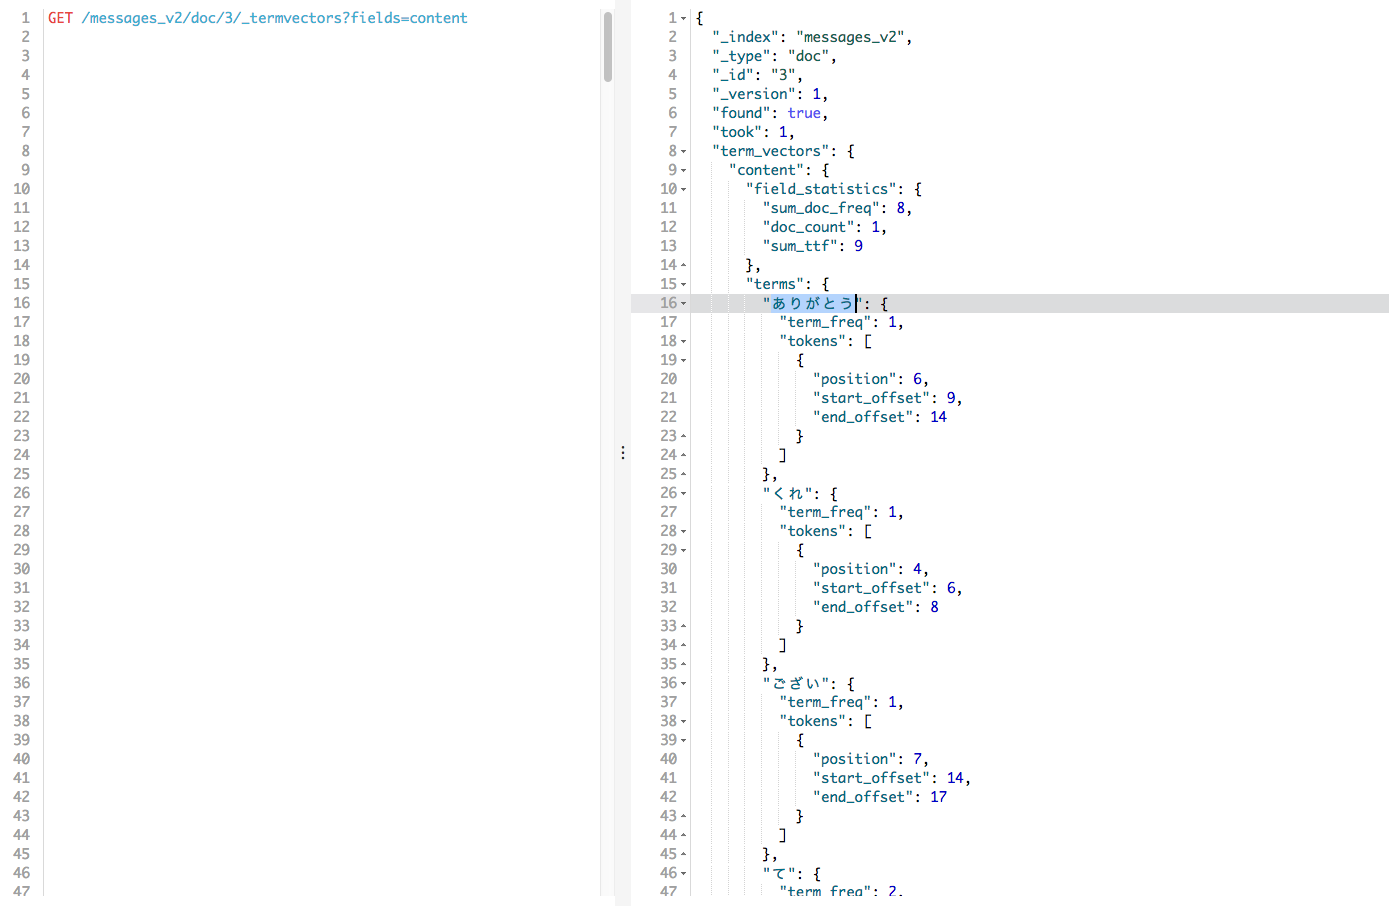
hoặc với mục đích testing analyzer thì 1/2 câu lệnh sau ngắn gọn hơn:
POST _analyze
{
  "tokenizer": "kuromoji_tokenizer",
  "text": "友達になってくれてありがとうございます"
}

POST messages_v2/_analyze
{
  "analyzer": "custom_analyzer",
  "text":     "友達になってくれてありがとうございます"
}
Bài viết trên được áp dụng trong trường hợp 1 node Elasticsearch nên mọi thứ chạy = cơm vẫn rất ổn thoả, nếu bạn sắp phải thao tác trên các hệ thống replica shards cần lưu ý thêm như:
- Tắt shard allocation trên cluster
- Thực hiện index flush sync …
- Graceful shutdown & restart & rejoin cluster
- Mở lại shard allocation trên cluster
- Cluster heathcheck →

green - Kế hoạch rollback nếu việc update bị fail

Tất nhiên để thực hiện chính xác và không bị mắc sai sót, ta nên tự động hoá các công việc đó với một vài công cụ như shell-script, ansible, puppet, … Chúc bạn thực hiện thành công =))